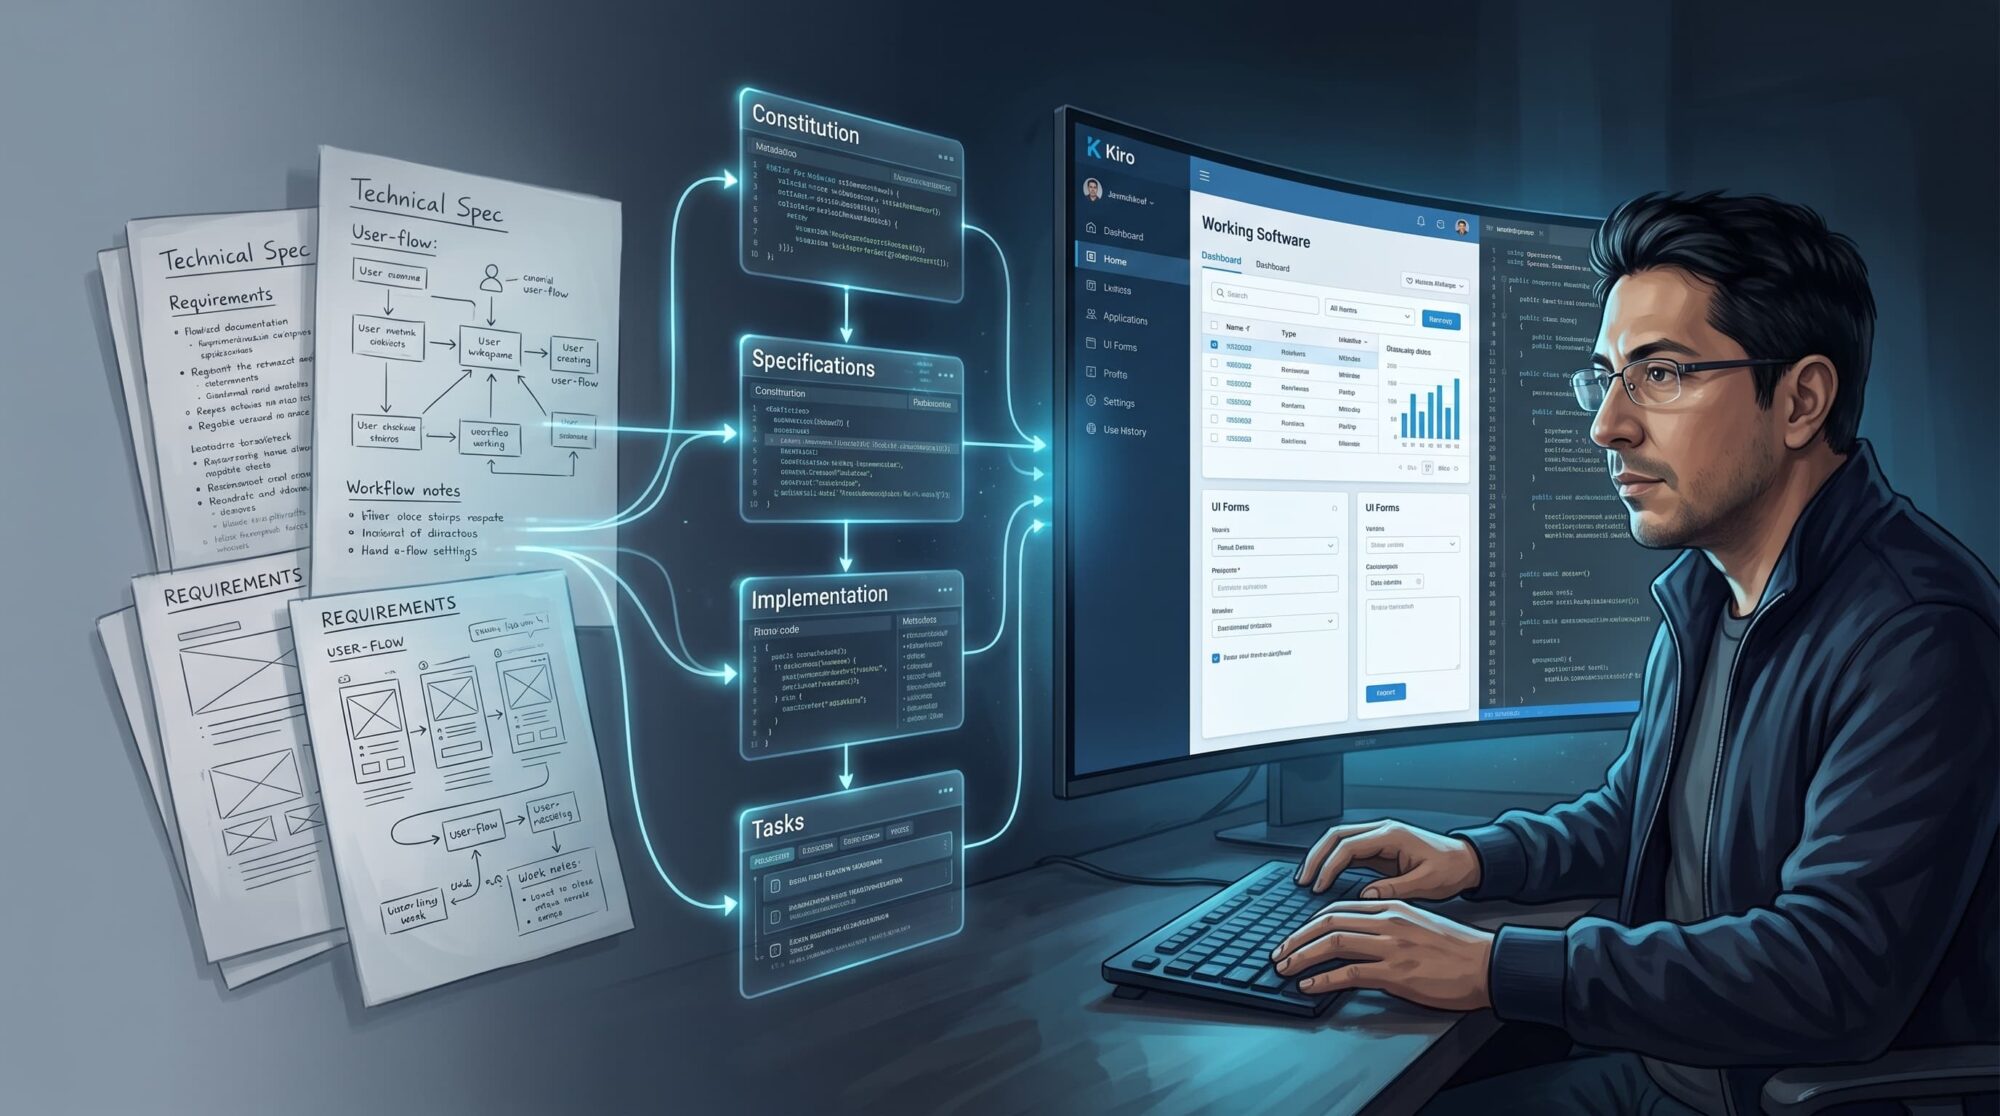
Cómo estoy incorporando el desarrollo guiado por especificaciones a mi forma de construir sistemas con .NET, SQL Server e inteligencia artificial.
Introducción: cambiar la forma de desarrollar
En los últimos años, las herramientas de inteligencia artificial han comenzado a modificar la manera en que desarrollamos software. Ya no se trata únicamente de pedirle a un asistente que explique un fragmento de código o que genere una función: ahora podemos apoyarnos en estas herramientas durante buena parte del ciclo de desarrollo de una aplicación.
Una de las propuestas que me ha llamado la atención es el Spec-Driven Development (SDD), o desarrollo guiado por especificaciones. La idea consiste, en términos generales, en partir de requisitos bien definidos y utilizarlos como referencia para planificar, organizar e implementar el software. En cierta forma, podría decirse que seguimos haciendo algo que conocemos desde hace tiempo: analizar, documentar y planificar antes de desarrollar. La diferencia es que ahora podemos utilizar esas especificaciones para guiar a una IA durante buena parte de la implementación.
Mi acercamiento a esta metodología ha sido principalmente práctico. He comenzado a utilizar Kiro en algunos proyectos en mi trabajo, buscando una forma de aprovechar la IA sin perder el control sobre las decisiones funcionales y técnicas.
No considero que haya encontrado una metodología perfecta ni que mi proceso sea una implementación estricta de SDD. De hecho, hay aspectos que todavía puedo mejorar. Pero después de trabajar con este enfoque en dos o tres proyectos, he identificado algunas ventajas, dificultades y aprendizajes que vale la pena compartir.
Y debo comentar, después de utilizar la IA integrada en Visual Studio y Visual Studio Code, conocí Antigravity, que fue la herramienta con la que hice mi primer sistema apoyado con este tipo de IDEs y, desde ese momento, cuando aún no conocía SDD, mi intuición no fue sentarme a hacer vibe code, sino me dije, “esto tiene que tener un orden, debo seguir desarrollando el documento de requerimientos, pero debo hacerlo más explícito, más completo, porque ahora ese documento se lo daré a una IA y ella debe entender y debe tener todos los detalles de lo que debe programar”.
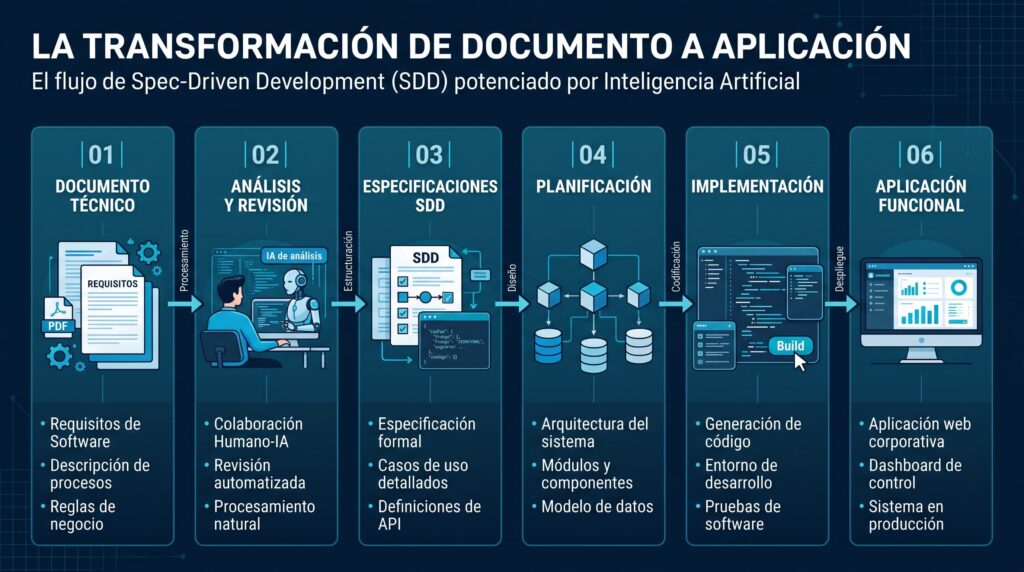
En este artículo quiero relatar cómo estoy trabajando actualmente: desde el documento técnico inicial hasta la implementación y las pruebas de una aplicación. Y deben tener en cuenta el antecedente, como fue que inició mi cambio en la forma de desarrollar.
1. Todo comienza con un documento técnico
Antes de utilizar Kiro, preparo un documento de requerimientos técnicos en Word. Dependiendo de la complejidad del sistema, este documento ha llegado a contener 50 y 70 páginas. Aquí, la comunicación con el área para la cual se está implementando el sistema es importante, debido a que los requerimientos que constituyen el documento técnico se obtienen a partir de las reglas de negocio del área.
No es un documento que empiece desde cero cada vez. Ya tengo una estructura y secciones que reutilizo entre proyectos, especialmente cuando se trata de funcionalidades comunes.
Por ejemplo, hay aspectos o funcionalidades que suelen repetirse:
- Notificaciones por correo electrónico cuando ocurren determinadas acciones.
- Registro de actividades de los usuarios mediante una bitácora o auditoría.
- Administración de usuarios y roles mediante Directorio Activo.
- Elementos comunes de la interfaz institucional.
Y algunos de los apartados que son parte de la estructura del documento son.
Roles y permisos
Primero identifico los diferentes perfiles que utilizarán el sistema. Puede haber administradores, empleados, responsables de áreas u otros perfiles dependiendo de la aplicación.
Interfaces y funcionalidades
Después describo las vistas a las que tendrá acceso cada rol. No me limito a enumerar pantallas: procuro explicar qué puede hacer cada usuario desde ellas.
En algunos casos incorporo imágenes de referencia para mostrar cómo espero que se comporte o se vea determinada interfaz.
Identidad visual
También incluyo las características generales que deben conservar las aplicaciones institucionales: colores, logotipo, encabezado, menús, identificación del usuario y, cuando corresponde, mecanismos para cambiar de rol.
Para ello utilizo algunas pantallas como referencia. También, aunque lo describo en el documento técnico, tengo una skill para el stack tecnológico y para la identidad visual y un archivo CSS que anexo al proyecto una vez que inicia la implementación.
Flujos de trabajo
Esta es una de las partes que considero más importantes. Describo los procesos que seguirá cada usuario y las condiciones que deben cumplirse durante su ejecución.
Por ejemplo, en un sistema de permisos, un empleado puede generar una solicitud que posteriormente recibe su jefe directo. Cuando la solicitud se envía, el empleado deja de poder modificarla. El jefe puede revisarla, devolverla con observaciones o autorizarla y así entre otras áreas. Es importante identificar los flujos a partir de las reglas de negocio del área, y más importante saberlas explicar y describir en el documento técnico ya que de estas descripciones surgen parte de la estructura de la base de datos y de la funcionalidad en las vistas de cada rol.
No basta con decir que existe un proceso de autorización: hay que explicar qué sucede en cada etapa, quién puede intervenir y qué acciones están permitidas.
Estructura de la base de datos
Finalmente, incluyo una sección dedicada a la base de datos, que normalmente trabajo con SQL Server.
En ocasiones propongo desde el inicio las tablas y entidades que logro identificar y que considero necesarias. Posteriormente, me apoyo en la inteligencia artificial para identificar elementos adicionales que quizá no había contemplado.
Este documento es, en realidad, el punto de partida de todo el proceso. Mi intención es que contenga suficiente información para que la herramienta comprenda qué debe construir, pero también que permita identificar oportunamente aquello que todavía no está definido.
2. Antes de desarrollar, utilizo la IA para revisar los requisitos
Una vez que tengo una primera versión del documento, comienzo un proceso de revisión utilizando dos herramientas: Copilot de Microsoft 365, directamente desde Word, y posteriormente Kiro.
Mi objetivo no es pedirles que completen el documento por su cuenta, sino que me ayuden a encontrar problemas que quizá no he identificado.
Con Copilot reviso principalmente cuatro aspectos:
- Ambigüedades en los requerimientos.
- Inconsistencias o contradicciones entre diferentes secciones.
- Funcionalidades que aparecen descritas varias veces y cuya redacción podría unificarse.
- Requisitos incompletos: situaciones en las que se menciona que el sistema debe realizar una acción, pero no se explica cómo debe hacerlo.
Este último punto me parece especialmente importante.
Si en el documento indico que el sistema debe enviar una notificación por correo electrónico cuando se autoriza una solicitud, pero no he definido en qué momento se envía, quién la recibe o qué información debe contener, quiero que la IA me señale esa ausencia.
No quiero que invente una solución y la incorpore automáticamente. Prefiero que me indique qué falta para que yo tome la decisión.
Cuando recibo las observaciones, complemento el documento y vuelvo a realizar la revisión. Repito el proceso hasta considerar que los requerimientos están suficientemente definidos.
Después exporto el documento a PDF y lo incorporo a Kiro para realizar una revisión similar.
De esta manera tengo dos revisiones asistidas que me ayudan a detectar problemas antes de comenzar el desarrollo.
Mi intención es utilizar la inteligencia artificial como una especie de revisor lógico de los requisitos, no como alguien que tome decisiones funcionales que todavía me corresponden.
3. El diseño de la base de datos también puede beneficiarse de la IA
También he comenzado a apoyarme en Kiro para diseñar las bases de datos. En un proyecto anterior, relacionado con la gestión de vehículos, le proporcioné los requerimientos y algunas entidades iniciales, como usuarios, documentos y vehículos. A partir de esa información propuso un modelo más amplio, incorporando tablas que no había considerado y que me ayudaron a identificar necesidades adicionales.
Para el proyecto actual quiero seguir un enfoque similar, pero partiendo de una propuesta inicial de estructura que Kiro pueda revisar y complementar. Una vez definido el modelo, le solicito generar el script SQL, que ejecuto y reviso junto con sus tablas, relaciones y diagrama entidad-relación.
Trabajo bajo un enfoque Database First: yo preparo y controlo la base de datos, y Kiro desarrolla la aplicación tomando esa estructura como referencia. Personalmente no me gusta que sea la aplicación, mediante Entity Framework, quien la modifique directamente durante la implementación; cualquier ajuste debe pasar primero por mi revisión.
Así aprovecho la capacidad de la IA para proponer y detectar elementos que podrían faltar, sin perder el control sobre las decisiones del diseño.
4. De los requisitos a las especificaciones con Kiro
Cuando considero que el documento técnico está suficientemente completo, paso a la siguiente etapa: utilizar Kiro para generar los artefactos necesarios para trabajar con SDD.
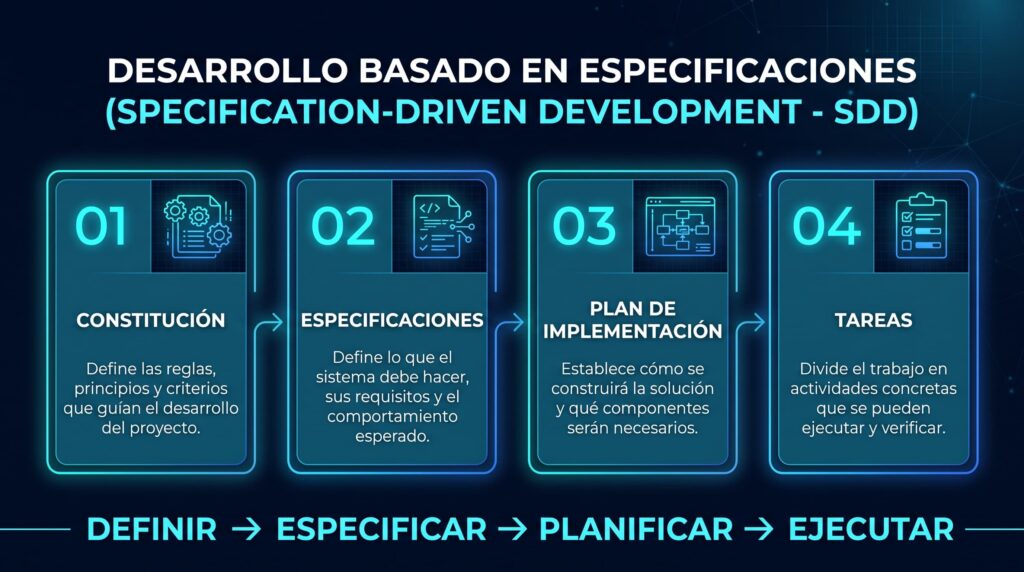
En este punto le proporciono el documento y le solicito que prepare los elementos que organizan el proyecto:
- Constitution: las reglas y principios que deben respetarse durante el desarrollo.
- Specifications: las especificaciones que describen lo que debe construirse.
- Plan: el plan de implementación.
- Tasks: las tareas en las que se divide el trabajo.
Estos elementos permiten transformar un documento técnico extenso en una estructura de trabajo más organizada.
También le solicito que revise los archivos generados y compruebe que sean congruentes con los requerimientos originales.
Aquí debo reconocer que mi revisión de estos artefactos todavía no es tan exhaustiva como probablemente debería ser. Hasta ahora he realizado una revisión general, confiando en buena medida en el resultado que proporciona Kiro. No he tenido problemas importantes que me obliguen a detener el proceso, pero considero que esta es una de las áreas que puedo mejorar.
En cuanto al modelo de inteligencia artificial, normalmente dejo Kiro en modo automático. Es la propia herramienta la que determina qué modelo utilizar según la tarea. No selecciono manualmente un modelo para cada actividad.
Una vez que considero que los artefactos están listos, comienzo la implementación.
5. Definir las tecnologías y dejar que Kiro resuelva parte de la implementación
En mis proyectos empresariales suelo trabajar con un conjunto de tecnologías bastante definido:
- .NET y C#.
- ASP.NET Core MVC.
- SQL Server.
- Microsoft Entra ID para la autenticación.
- Telerik y Kendo UI para los componentes de interfaz.
También incluyo indicaciones relacionadas con la seguridad. Por ejemplo, solicito que el desarrollo considere las recomendaciones de OWASP y que se eviten vulnerabilidades como SQL Injection.
Sin embargo, no defino absolutamente todos los detalles de la organización interna del código.
Por ejemplo, sí establezco que el proyecto debe utilizar MVC, pero no siempre especifico de antemano cómo debe implementar cada controlador o cómo organizar todos los componentes internos.
En ocasiones le indico expresamente cómo quiero que genere determinados controladores. En otras, dejo que proponga una solución y después reviso si me parece lógica y adecuada.
También hay decisiones de arquitectura y configuración que sí procuro dejar claras.
Un ejemplo es el almacenamiento de parámetros de negocio. Si estoy desarrollando un sistema de control de asistencia y existe una tolerancia de 15 minutos para determinar si un empleado llegó tarde, prefiero que ese valor se almacene en una tabla de configuración de SQL Server y no directamente en el archivo appsettings.
De esta manera, si posteriormente cambia la regla, puede modificarse el parámetro sin necesidad de alterar el código de la aplicación.
Mi enfoque consiste en definir las tecnologías, las restricciones importantes y las reglas de negocio que deben respetarse, pero permitir que Kiro resuelva parte de los detalles de implementación.
No significa que cualquier decisión que tome sea correcta: sigue siendo necesario revisar el resultado.
6. La implementación: trabajar con las especificaciones
Cuando comienza la implementación, suelo trabajar con las especificaciones en el orden en que fueron generadas, desde la primera hasta la última.
No acostumbro detenerme después de cada especificación para realizar una validación funcional completa. Dejo que Kiro avance con la implementación de todas ellas y, cuando termina, comienzo una etapa de revisión más amplia.
Esta forma de trabajar tiene una ventaja práctica: puedo obtener una primera versión navegable de la aplicación sin tener que intervenir constantemente entre cada tarea.
Pero también tiene una consecuencia: algunos problemas de integración o de interpretación de los requisitos pueden aparecer hasta que la aplicación está construida y comienzo a utilizarla.
Por eso, la implementación no representa el final del trabajo. Es el momento en que comienza una etapa que considero indispensable: comprobar que el sistema realmente haga lo que se espera de él.
7. Probar la aplicación: la parte que sigue dependiendo de mí
Una vez que Kiro termina de implementar la primera versión, ejecuto la aplicación en mi entorno local y comienzo a probarla.
Para ello preparo una base de datos local y diferentes cuentas de prueba, procurando representar los roles que intervienen en el sistema.
Si una aplicación contempla empleados, superiores jerárquicos y operadores de áreas, por ejemplo, tengo cuentas que me permiten simular a cada uno de esos perfiles.
Después recorro los procesos de principio a fin, intentando reproducir los pasos que seguiría un usuario real.
Durante estas pruebas identifico problemas de distintos tipos:
- Errores visuales o de distribución de los elementos.
- Funcionalidades que no se comportan como deberían.
- Información que no se guarda correctamente en la base de datos.
- Notificaciones que no se envían.
- Errores de programación que aparecen durante la ejecución.
También utilizo las herramientas de desarrollo del navegador (DevTools) para identificar errores y localizar información que pueda ayudarme a encontrar su origen.
Cuando detecto un problema, se lo comunico a Kiro para que realice la corrección.
Aquí tengo dos formas de trabajar.
Si encuentro un error que no impide continuar con las pruebas, lo documento junto con otros ajustes y sigo revisando el sistema. Por ejemplo, puedo registrar que una operación no guarda correctamente cierta información o que no se dispara una notificación de correo electrónico.
Si el problema bloquea el proceso que estoy probando, detengo la revisión y me concentro en corregirlo con Kiro antes de continuar.
Esta etapa se convierte en un ciclo de pruebas, identificación de problemas, correcciones y nuevas validaciones.
En otras palabras, aunque la IA realiza buena parte de la implementación, soy yo quien comprueba que el resultado responda a las necesidades reales del sistema.
8. Los cambios posteriores: una adaptación de mi proceso
Una situación interesante aparece cuando la aplicación ya está implementada y comienzan a surgir nuevas necesidades.
En un proceso SDD más estricto, lo ideal sería mantener las especificaciones actualizadas y documentar los cambios dentro de esa misma estructura.
Sin embargo, en mi experiencia todavía no trabajo exactamente de esa manera.
Cuando necesito incorporar nuevas funcionalidades o realizar correcciones, preparo un documento independiente con los ajustes solicitados. Es un documento más puntual que el original, pero sigue una lógica similar: describo qué debe modificarse, qué comportamiento espero y qué funcionalidades nuevas deben incorporarse.
Después se lo proporciono a Kiro para que realice los cambios.
Las especificaciones iniciales permanecen sin modificaciones.
Es una adaptación práctica que me ha permitido continuar trabajando, aunque reconozco que podría mejorar la trazabilidad entre los requerimientos originales, los cambios posteriores y el código implementado.
Mantener esa relación actualizada ayudaría a que la documentación siguiera siendo una referencia confiable durante toda la vida del sistema, y no solamente durante su construcción inicial.
9. ¿Qué tan cerca está la primera versión del resultado esperado?
Una de las preguntas que me parece más interesante después de utilizar este enfoque es: ¿qué tan bien queda una aplicación en su primera versión?
Mi estimación personal es que la primera versión que comienzo a navegar y probar se acerca aproximadamente a un 50 o 60 % de lo que realmente necesito.
No se trata de una medición formal ni de un porcentaje de código correcto. Es una apreciación basada en qué tan cerca está el resultado inicial de lo que tenía en mente y de lo que describí en los requerimientos.
En términos funcionales, normalmente encuentro que la aplicación está razonablemente encaminada. Sin embargo, donde suelo identificar más diferencias es en el diseño y la organización visual de las pantallas.
10. Lo que he aprendido y lo que todavía puedo mejorar
Después de trabajar con SDD y Kiro en algunos proyectos, mi principal aprendizaje es que la calidad del resultado depende en buena medida del trabajo previo, de la calidad del documento técnico inicial.
Un documento técnico incompleto o ambiguo puede convertirse en una implementación que funcione, pero que no resuelva realmente la necesidad.
Por eso considero que dedicar tiempo a definir los requerimientos y revisarlos con ayuda de la IA es una de las partes más importantes del proceso.
También he comprobado que la inteligencia artificial puede ayudar a descubrir entidades, relaciones y funcionalidades que quizá no había contemplado inicialmente. Esto no significa que debamos aceptar todas sus propuestas, sino utilizarlas como una segunda perspectiva que enriquezca nuestro análisis.
Por otro lado, hay aspectos de mi proceso que quiero mejorar:
Revisar con mayor profundidad los artefactos SDD. Hasta ahora he confiado bastante en la revisión general que realiza Kiro. Me gustaría dedicar más tiempo a comprobar que las especificaciones y tareas reflejen correctamente los requisitos originales.No es un pretexto pero, un motivo de porqué no he dedicado tiempo a revisar los artefactos de SDD es porque el tiempo que tengo disponible para entregar el sistema solicitado no es tan amplio como antes de la era de la IA.
por poner un ejemplo, estamos desarrollando un sistema para la gestión de asistencias en la empresa, dada la complejidad y el tamaño del sistema, debería poder contar con unos 3 o 4 meses para desarrollarlo…, pues no, solo tengo poco más de un mes para entregar el producto final, y eso sin contar que no se está trabajando con tiempo exclusivo para el proyecto, ya que hay que trabajar en otras actividades de manera conjunta.
Validar la arquitectura del código. Aunque defino las tecnologías y algunas reglas, todavía puedo establecer criterios más precisos sobre la organización interna de los proyectos.
Mejorar la trazabilidad de los cambios. Los documentos independientes de ajustes me han resultado prácticos, pero mantener las especificaciones actualizadas permitiría conservar una mejor relación entre lo que se solicitó y lo que finalmente se implementó.
Fortalecer la validación de seguridad. Indicar a Kiro que siga recomendaciones de OWASP es un buen punto de partida, pero no sustituye una revisión de seguridad más sistemática. Es un aspecto que merece atención independiente de las pruebas funcionales.
No considero que estos puntos invaliden mi experiencia actual. Al contrario, forman parte de lo que he aprendido al incorporar estas herramientas a un proceso de desarrollo real.
Conclusión: la IA desarrolla, pero las decisiones siguen siendo nuestras
El desarrollo guiado por especificaciones me ha permitido replantear la forma en que abordo la construcción de aplicaciones empresariales.
Antes de escribir código, dedico tiempo a estructurar los requisitos, definir los roles, describir los flujos de trabajo y revisar las necesidades del sistema. Después utilizo herramientas como Copilot y Kiro para encontrar inconsistencias, enriquecer el diseño y transformar esa documentación en una estructura de trabajo que facilite la implementación.
Kiro se encarga de buena parte del desarrollo, pero eso no significa que pueda desentenderme del resultado. Al final de cuentas, es muy cierto lo que ya se dice, cuando el sistema falle, la responsabilidad no será de la IA, será del humano que utilizó la IA, a quien corran, si las cosas van muy pero muuuuuy mal, será a Ángel Vera, no a Kiro.
Sigo definiendo las reglas de negocio, tomando decisiones sobre la base de datos, estableciendo las tecnologías, probando los procesos y revisando las correcciones.
También sigo encontrando aspectos que necesitan intervención, especialmente en la presentación visual y en algunos detalles de comportamiento.
Quizá la principal diferencia no está en que ahora una IA escriba el código por mí, sino en que he comenzado a utilizarla dentro de un proceso más estructurado.
Y eso cambia la manera de trabajar.
No le entregué a una IA la responsabilidad de desarrollar una aplicación; fui construyendo un proceso para que me ayudara a transformar mis requisitos en software funcional.
Referencias para profundizar
Estas son algunas fuentes oficiales que complementan los temas abordados en el artículo:
- Kiro — Specs: documentación sobre el desarrollo guiado por especificaciones en Kiro.
- Kiro — Models: información sobre los modelos disponibles y su utilización.
- OWASP Top 10: referencia sobre los principales riesgos de seguridad en aplicaciones web.
- Curso SDD Udemy: un curso que me ayudó mucho a entender el tema de SDD.